VISION PRO / GEMINI LIVE / OPEN SOURCE
SpatialYOLO 教程:在 Vision Pro 上接入 Gemini Live 实时视觉助手
从真实演示到开源代码:配置 Vision Pro 主摄像头权限、运行 SpatialYOLO,并理解 Gemini 3.1 Flash Live 的音视频链路、迁移细节与延迟排查。
我把 SpatialYOLO 接入 Gemini 3.1 Flash Live 后,最直观的感受是对话等待变短了。3 月 30 日发布演示时,我还特意记下:英语对话感觉更跟得上节奏,中文仍能感觉到一些停顿。这是当时的体验记录,没有统一条件下的延迟统计,也不能据此认定英语一定比中文快。
另一个更值得分享的细节是:我起初以为从 2.5 升到 3.1 只要换模型名,结果遇到了错误。随后参照官方示例,让 Codex 调整 API 调用,才完成迁移。这段过程记录在我的 YouTube 演示说明中,也发布到了 Reddit Vision Pro 社区。
这篇教程把演示拆成一条可以检查的路径:先确认摄像头可用,再接通声音,最后让 AI 围绕眼前的画面回答。
先看结果:SpatialYOLO 做了什么?
SpatialYOLO 是我开源的 Apple Vision Pro 项目,包含两条相邻的功能链路:Spatial YOLO 在设备端做物体检测和双目深度估计;AI Live 把采样画面与语音接入实时多模态服务,显示回复字幕并播放语音。本文聚焦 Gemini 路径,Qwen 和 OpenClaw 扩展可以在完成基础流程后再研究。
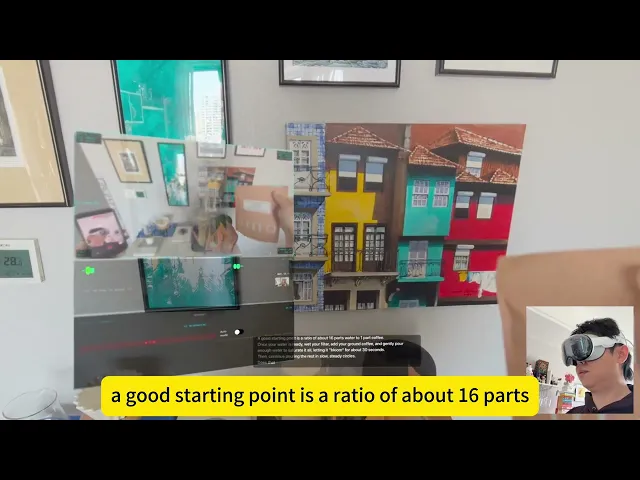
阅读前提:会在 Xcode 中选择 target、配置签名和运行真机。预计需要完成代码下载、权限配置、模型资源检查和一次完整对话;企业权限申请时间不包含在操作时间内。
版本基线:本文核对的是公开仓库与本地一致的提交 b079306(2026-03-29),资料查阅日期为 2026-09-15。README 仍保留 2.5 模型与 Xcode 16.2+ 的旧说明;代码中的 Gemini 模型已更新,应用 target 的部署目标为 visionOS 26.0。复现这个提交应使用包含 visionOS 26 SDK 的 Xcode 与符合部署目标的真机,不能只照 README 的旧最低版本准备环境。查看固定版本代码
一、先分清本地检测和云端对话
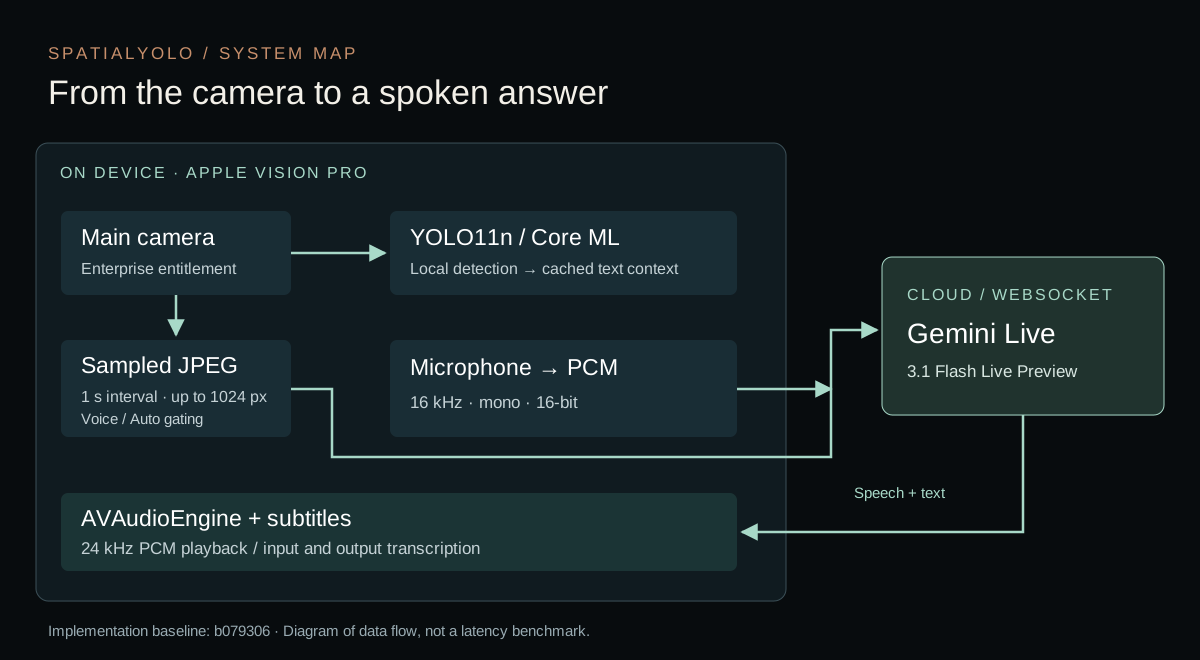
AI Live 并没有把摄像头的每一帧都上传。AppModel.swift 用 1 秒间隔限制采样;AppModel+GeminiLive.swift 在后台缩放画面,长边不超过 1024 像素,以 0.8 质量编码为 JPEG,再交给服务发送。非 Auto 模式还受语音活动控制:代码检测到输入音量超过阈值后激活采样,AI 开始回复时停止这轮采样。因此,“摄像头预览在刷新”与“正在发送新画面”要分别观察。
| 数据 | 这个提交的处理方式 | 排查重点 |
|---|---|---|
| 摄像头图像 | 左摄像头采样 → JPEG → realtimeInput.video |
是否有新帧、是否进入采样状态 |
| 麦克风 | 单声道、16-bit PCM、16 kHz → realtimeInput.audio |
权限、转换格式、输入音量 |
| 模型声音 | 24 kHz PCM → AVAudioEngine |
播放格式和音频队列 |
| 字幕 | 输入/输出转写 → 对话格式化 → 界面 | 是否收到转写事件 |
| 检测上下文 | 先缓存在服务内,再合入显式文本请求 | 缓存不等于每帧已发给模型 |
这些数值来自项目的 Gemini 服务及帧处理代码。理解这张表,就能把黑屏、无声、旧画面和字幕缺失分开定位。
二、准备主摄像头权限
这一步往往先于 API Key 决定能否复现。Apple Vision Pro 的透视显示,并不自动意味着应用可以读取主摄像头像素。
按 Apple 的企业 API 说明,为应用申请 Main Camera Access;获批后,把对应且有效的 .license 文件加入 target,并在 Signing & Capabilities → + Capability → Main Camera Access 中添加能力。许可证有有效期,签名或授权不匹配都需要先处理。
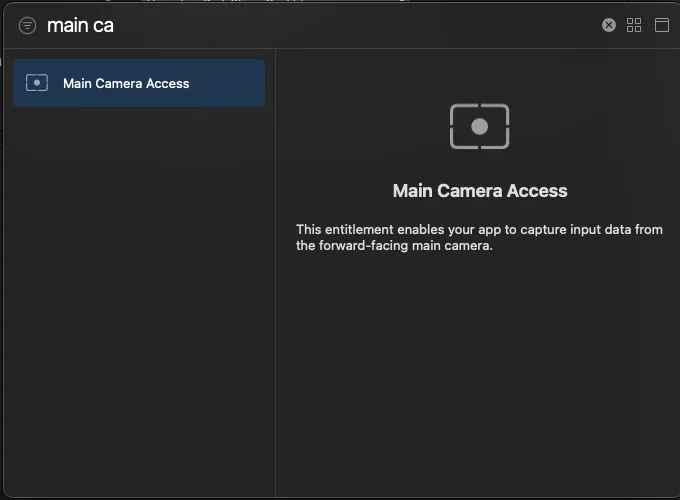
同时检查 Info.plist 中的主摄像头用途说明 NSMainCameraUsageDescription,以及麦克风用途说明。首次在设备上运行时允许相应访问。Apple 的主摄像头示例解释了许可证与用途说明的要求。
当前项目启动时会检查许可证状态和 mainCameraAccess 批准情况。先让真机摄像头预览正常,再排查 Gemini;模拟器不能作为实际摄像头、麦克风和空间体验的验收证据。
三、下载固定版本,检查模型资源
新建一个目录克隆仓库,固定到本教程核对的提交:
git clone https://github.com/lazygunner/SpatialYOLO.git
cd SpatialYOLO
git checkout b079306f3f0035c4d6f73afe8a784f821733b53c
open SpatialYOLO.xcodeproj
固定提交会进入 detached HEAD,适合复现;准备修改时可以自行新建开发分支。项目已包含 yolo11n.mlpackage 与 RaftStereo512.mlpackage,第一次运行优先使用这些资源,不必先训练模型。
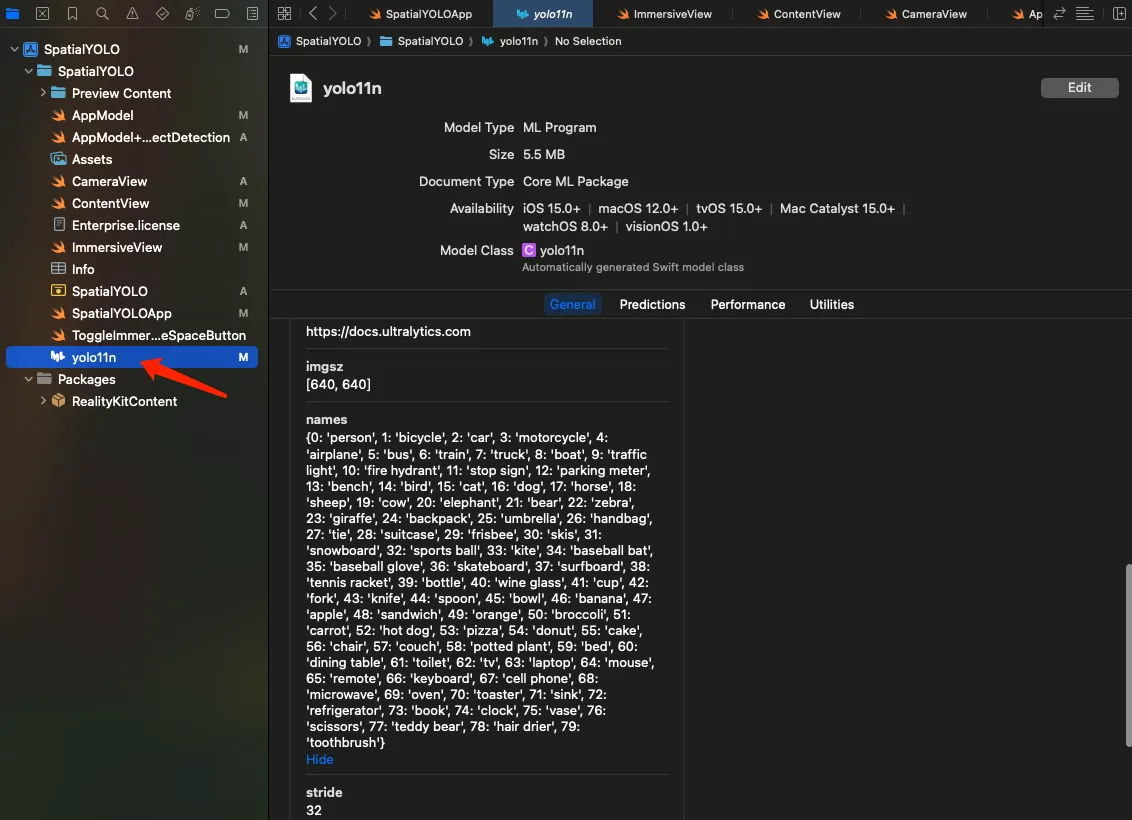
如果你需要重新导出 YOLO11n,可以在独立 Python 环境中按项目流程执行:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install ultralytics
yolo export model=yolo11n.pt format=coreml nms=true
这是可选步骤,本次写作没有重新执行模型导出。记录实际使用的 ultralytics、coremltools 和 Python 版本;如果导出失败,按错误信息核对工具兼容性。把导出的 .mlpackage 加入应用 target,避免重复添加同名资源。nms=true 对应导出时包含非极大值抑制;具体支持情况参考 Ultralytics Core ML 导出文档。
四、配置 Gemini Key,并确认它被打包
从 Google AI Studio 获取具有所需模型访问能力的 Gemini API Key。在仓库根目录执行:
cp SpatialYOLO/Config.plist.example SpatialYOLO/Config.plist
在 Config.plist 的 GEMINI_API_KEY 中填入自己的 Key。下面仅展示对应条目,不是完整 plist:
<key>GEMINI_API_KEY</key>
<string>YOUR_GEMINI_API_KEY</string>
确认 Xcode 会将这个文件打包到应用:检查 target membership 或 Build Phases 中的资源设置,保证 Bundle.main 能找到 Config.plist。文件在磁盘上存在,不等于已经进入应用包。
AppModel.loadGeminiAPIKey() 从应用资源读取这个键;找不到有效值会打印配置警告。只测试 Gemini 时不需要先申请 Qwen 的 Key。仓库忽略了真实配置和许可证,但把长期 Key 打包进客户端只适合作为个人开发配置;面向其他用户分发时,应另行设计服务端凭据与访问控制,不要把个人密钥随应用分享。
五、理解 2.5 → 3.1 的四处迁移
Google 模型页确认了 gemini-3.1-flash-live-preview 这个 Live API 模型标识。普通文本模型的名字不能直接替代它。
对照本项目,迁移至少要检查四处:
- 模型名。服务内部使用
models/gemini-3.1-flash-live-preview。 - 文本发送。
sendTextMessage()发送realtimeInput.text。sendDetectionContext()只暂存上下文,等待显式文本请求合并发送。 - 回合包含哪些画面。setup 显式指定
TURN_INCLUDES_ONLY_ACTIVITY;这会影响视觉输入如何参与回合。照抄不同版本示例前要核对默认行为。 - 响应解析。遍历
modelTurn.parts,并继续处理转写字段,不要读取一个文本片段后就跳过同一事件的音频。
下面摘录 setup 的关键结构,省略了声音选择和系统提示词,便于定位;不是完整替换函数:
let setup: [String: Any] = [
    "setup": [
        "model": "models/gemini-3.1-flash-live-preview",
        "generationConfig": ["responseModalities": ["AUDIO"]],
        "inputAudioTranscription": [:],
        "outputAudioTranscription": [:],
        "realtimeInputConfig": [
            "turnCoverage": "TURN_INCLUDES_ONLY_ACTIVITY"
        ]
    ]
]
完整实现见固定版本的 GeminiLiveService.swift。迁移规则和数据格式再与 Live API capabilities 对照。代码中的 setupComplete 才表示会话已配置就绪,仅仅打开 WebSocket 还不够。
六、在 Vision Pro 上完成第一次对话
在 Xcode 中配置自己的 Team、Bundle Identifier 和授权匹配的签名,选择已配对的 Vision Pro 真机运行。依次检查:
- 进入 AI Live 功能,确认摄像头画面正常显示。
- 选择 Gemini,点击 启动 / START。
- 在日志里确认
[GeminiLive] Setup 完成,连接就绪,再检查麦克风输入反馈。 - 先关闭 Auto 模式,面对一个清晰、静止的物体,开口问“请用一句话描述我面前的物体”。观察是否开始发送帧,以及是否同时出现声音与字幕。
- 换一个物体,再问一次。答案应根据新画面变化;这样可以排除模型只沿用上一轮上下文的情况。
- 停止再启动一次,然后持续使用超过两分钟,观察断开与重连是否符合预期。
这里是建议的真机验收流程。本次文章制作完成了源码与资料核对,没有替读者在另一台 Vision Pro 上重新跑过这些步骤。
七、怎样排查“慢”,以及两处现有边界
不要把所有等待都记在模型名下。一次回答涉及语音结束判断、当前画面采样、网络传输、服务生成、音频接收与播放队列。可以给每轮记录五个时间点:最后一个用户语音采样、最后一帧提交、首个响应音频块接收、首个音频块实际播放、回答结束。
先用“首个音频实际播放 − 用户最后一个语音采样”衡量用户可感知的等待,再分开记录网络错误、重连和首次连接。播放节点排队的时刻不能当作已经听到声音。保持设备、网络、提示词、回答长度、采样方式一致,分别做中英文样本,报告样本量、中位数与 P95,才能讨论差异。本教程不提供未经测量的毫秒数字。
| 现象 | 优先检查 |
|---|---|
| 摄像头黑屏 | 许可证有效期、entitlement、签名、用途说明与用户授权 |
连接后没有 setupComplete |
Key 权限、模型标识、setup 字段和网络错误 |
| 能对话,但看不到新物体 | isVoiceSamplingActive、输入音量阈值、帧发送日志;确认提问时物体已经入镜 |
| 有字幕但无声 | 是否收到 inlineData,24 kHz PCM 播放格式和音频引擎状态 |
| 总在两分钟左右重连 | 当前客户端有 120 秒计时器,会主动断开并触发重连 |
| 打断后旧语音还在播放 | 收到中断事件后是否真正停止并清空已排队音频 |
最后两项值得单独看代码。120 秒是这个提交的客户端行为,不能写成 Gemini 3.1 的统一服务上限。当前 sessionResumptionUpdate 处理只打印事件,没有完成恢复句柄的持久化与复用;自动重连也不能直接等同于无损续聊。
中断同样有边界:显式发送文本时会停止并重启播放节点,但 interrupted 分支只更新说话状态和字幕,没有同样清理播放队列。要改造成稳定的语音产品,需要补充这条路径并在真机验证。这是对源码的检查结果,不是本次听到了某个特定故障。
常见问题
没有 Main Camera Access,能完整复现吗?
无法完整复现主摄像头画面驱动的体验。可以先独立验证 API 连接或音频链路,但这不代表已经接入 Vision Pro 的真实环境画面。
必须自己训练 YOLO 吗?
不需要。这个提交已包含模型包,先验证现有资源和 target 配置。只有识别类别或模型需求改变时,才进一步研究训练、导出和性能。
为什么 README 写 Gemini 2.5?
README 的模型说明尚未同步。本文固定提交中的服务代码已使用 Gemini 3.1 Flash Live;后续复现请同时记录提交号、实际模型名和官方文档日期。
这是一套完全离线的助手吗?
不是。YOLO 检测在设备上运行,Gemini 对话需要把采样图像和音频发送给云端服务。请用适合测试的环境和素材验证,不要把设备端检测误认为整条链路都在本地。
换成 3.1 就一定更快吗?
我在视频说明里记录了主观改善,但没有提供受控对比数据。网络、语言、回合检测和播放队列都会影响结果,具体改善应在相同条件下测量。
从演示走向自己的空间助手
先拿一个物体完成一次“看到—提问—听到回答”,然后验证换物体、打断、重连。这几项都稳定后,再考虑连续讲解、设备说明、展品导览或其他业务场景。
SpatialYOLO 留下的可复用经验,是把画面是否更新、会话是否就绪、声音是否真正播放分别做成可观察的状态。这样,下一次换模型或增加服务商时,就有一条能重新检查的路径。